16 Sep 2026
Я сделал маленький эксперимент на один вечер. Ага, который занял неделю, и это был лучший месяц моей жизни.
Идея простая: нейронка не отвечает сразу, а делает несколько шажочков, которые я задаю руками. Вдобавок у неё есть память, в которую можно что-то сохранить или переписать. Такой агент получается заметно умнее, но, к сожалению, заметно медленнее.
Ничего радикально нового я не изобрёл, просто было интересно потыкаться. Код тут: github.com/Kright/FlowChar. Всё навайбкожено, работает с любой локальной моделью через OpenAI-совместимый API (LM Studio, llama-server и т.п.). Платные облачные нейронки я не использовал, мне было интересно что можно выжать из локальных.
Как оно устроено
“Мышление” персонажа - это папка с yaml-файлами и промптами, по одному агенту на файл. Агент - это один вызов нейронки: системный промпт, пользовательский промпт и, опционально, схема JSON-ответа. У каждого агента есть список зависимостей, из них получается DAG. Корневой агент называется voice, его текст и есть ответ игроку. Движок выполняет voice и всё, от чего он зависит, а независимые агенты запускаются параллельно.
Состояние мира - один большой JSON. Менять его агенты могут только через список операций (set, add, append, remove по пути), которые нейронка возвращает в ответе. Это удобно тем, что каждое изменение видно и его можно откатить.
Например, схема для гейм-мастера ролевой игры выглядела так:
- После ответа игрока параллельно работают три агента: один записывает новые факты в память, второй обновляет состояние игрока (здоровье, инвентарь), третий - состояние сцены.
- Потом агент-режиссёр получает всю обновлённую информацию и решает, что дальше происходит.
- И последний шаг -
voiceформирует текст для игрока.
Если просить нейронку сделать всё сразу одним вызовом, она что-нибудь забудет. А когда вызов явно говорит “проанализируй состояние персонажа и обнови его” - всё ок.
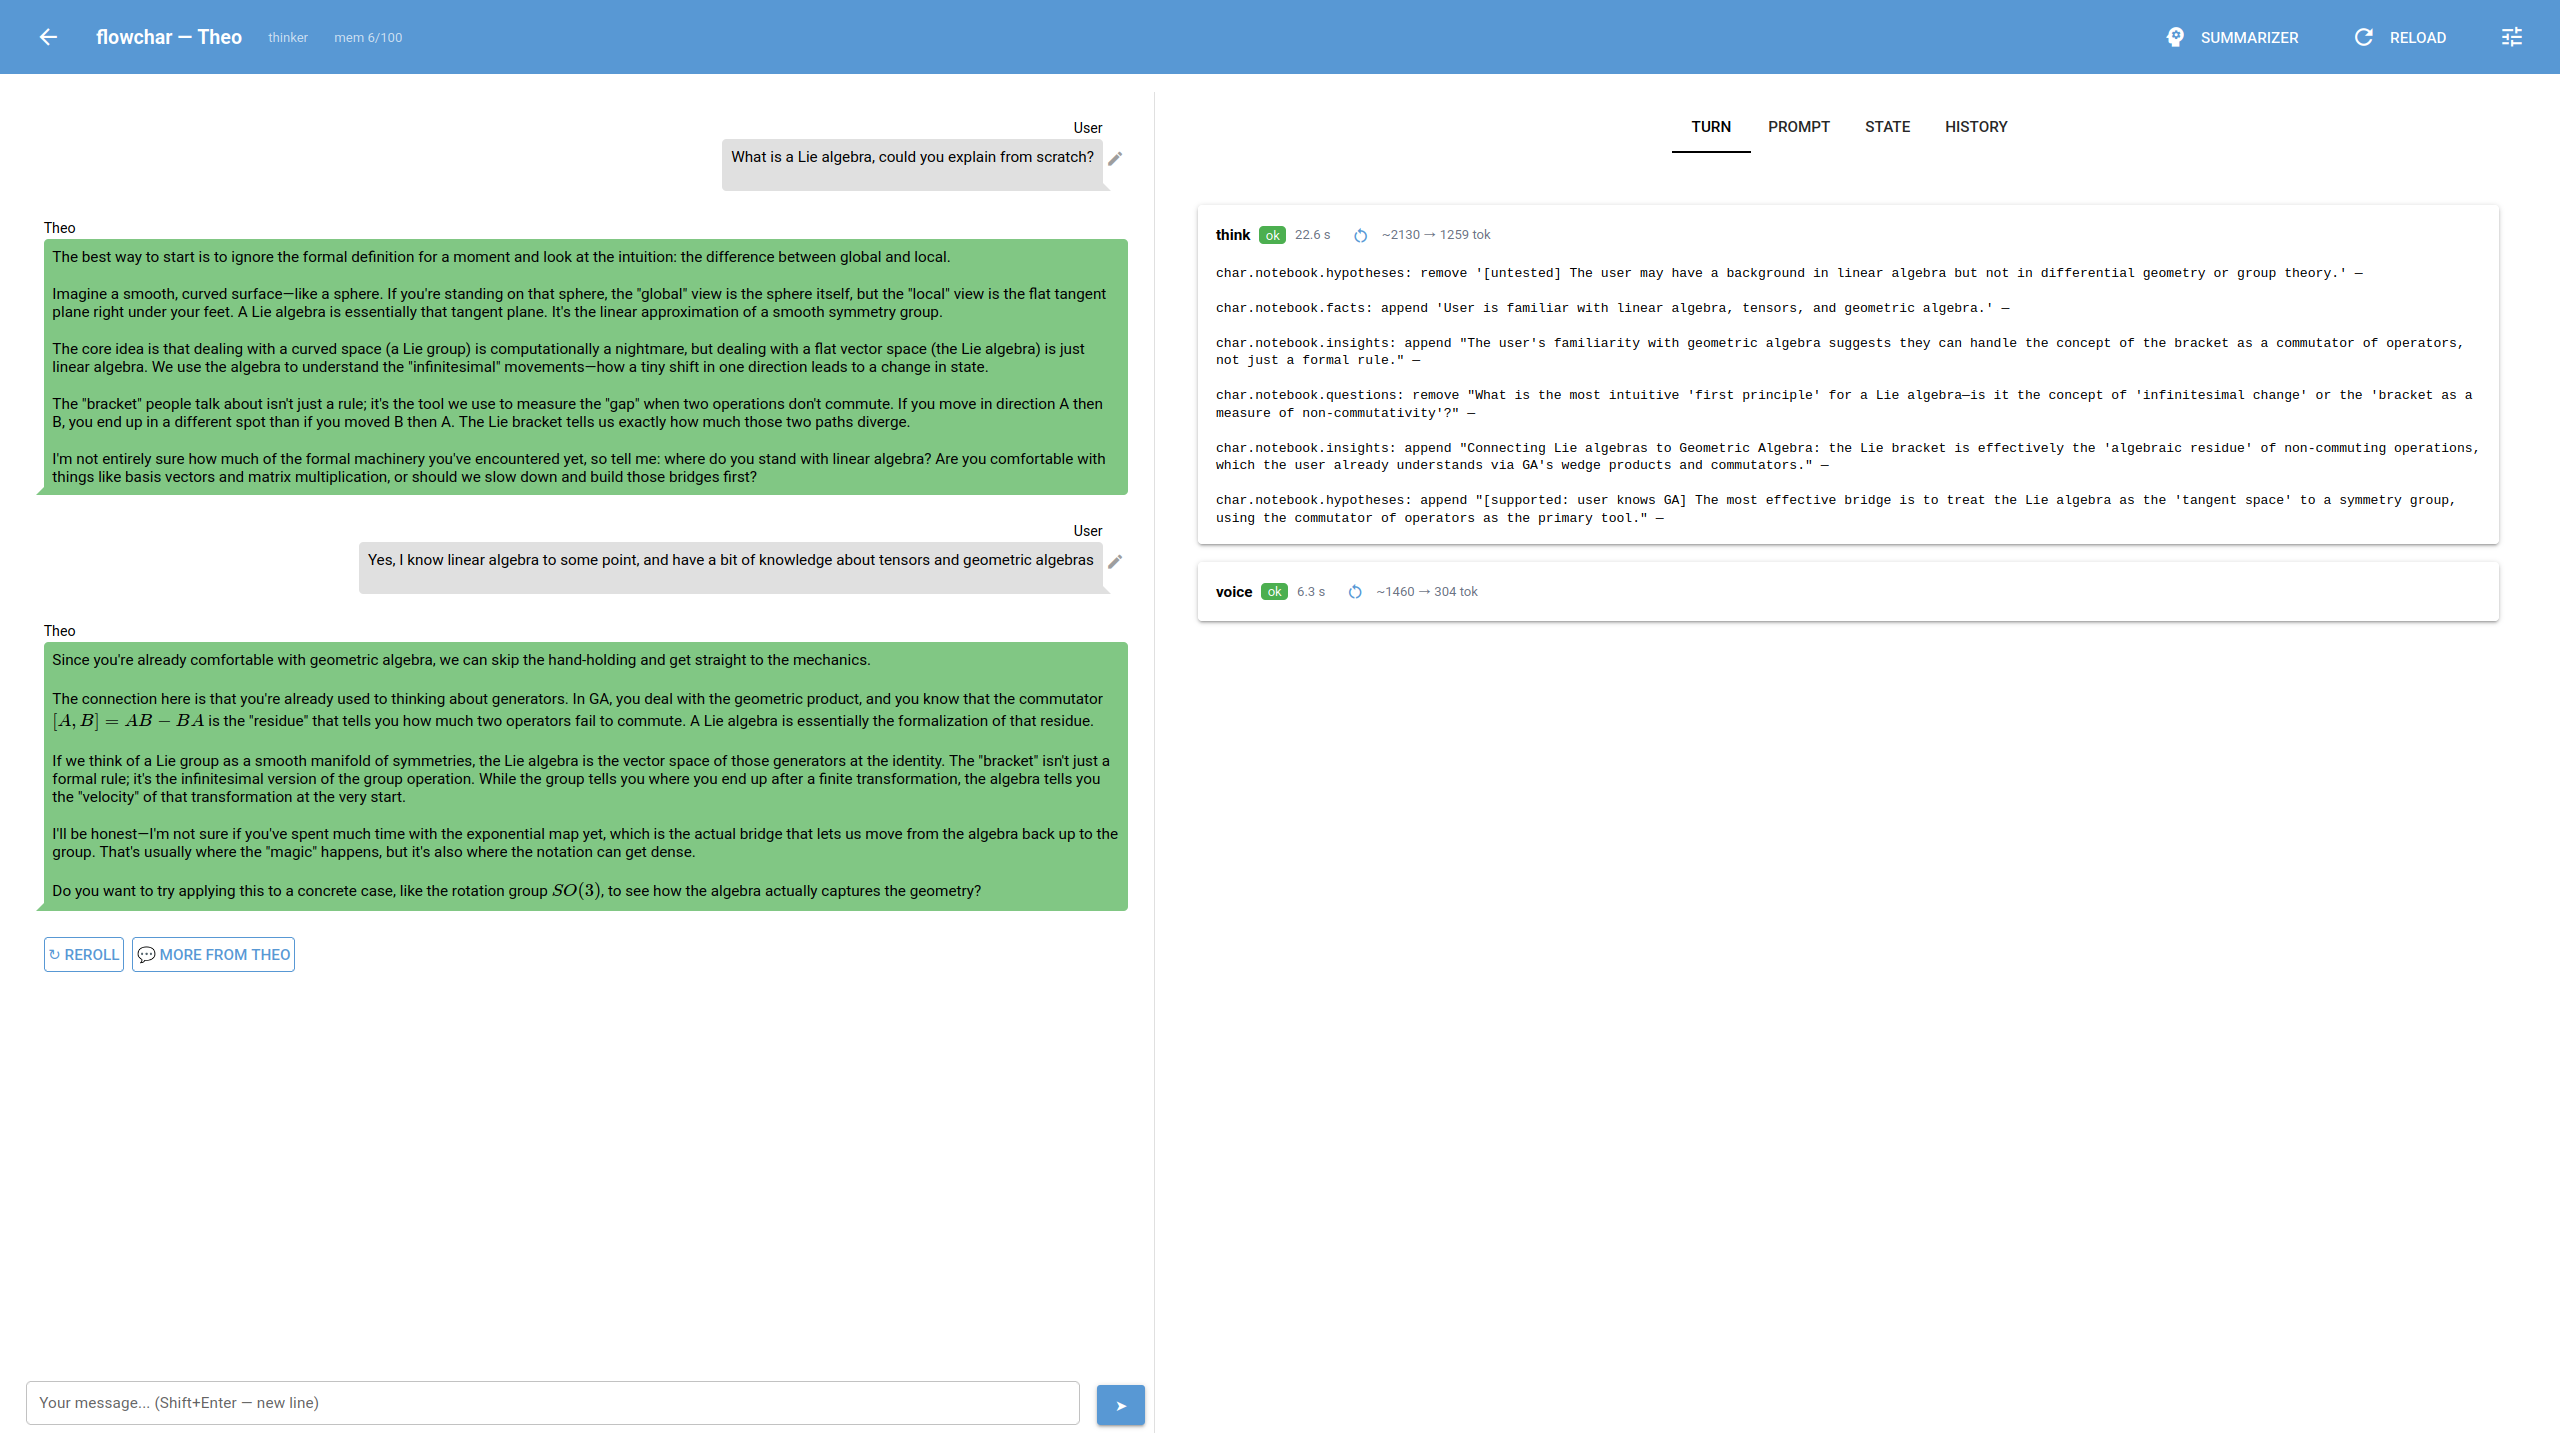
Ещё есть схема thinker: агент много раз подряд крутится над блокнотом с фактами, гипотезами и открытыми вопросами, пока не решит, что понял достаточно. И только потом пишет ответ.
Питоновское ядро при этом маленькое и не меняется: новый агент или новая схема мышления - это просто новые файлы. Промпты перечитываются с диска на каждом вызове, так что их можно править прямо по ходу диалога.
Отдельно я вложился в отладку: для каждого хода видно, какие агенты вызывались, что именно увидела модель в промпте, что она ответила и как поменялось состояние. Каждый ход - снапшот, можно откатиться назад, отредактировать своё сообщение и переиграть с этого места веткой.
Что получилось
Такой агент реально умнее обычного чата: держит факты из диалога и точно знает, сколько у игрока очков здоровья. Промпты я подкручивал по ходу дела.
Из минусов - gemma 31b на моём железе ну совсем медленно ворочается, вся интерактивность убивается. Можно взять gemma 12b, с ней побыстрее, но всё равно в разы медленнее, чем общение с нейронкой напрямую. Оно и понятно: вместо одного вызова на ход их получается несколько.
Забавное наблюдение: я ускорил вычисления на порядок, когда отключил размышления (thinking). Причём частично их можно оставить. Если первым полем JSON-ответа сделать поле thoughts, нейронка там всё равно подумает, а потом уже заполнит поля с решениями. Наверно, я потерял в качестве, но на мой взгляд 12b с размышлениями была глупее, чем 31b без размышлений, а по времени 31b без размышлений была быстрее. Так что я остановился на таком варианте.
Выводы
- Разбиение на маленькие шаги с явной задачей работает: нейронка перестаёт забывать половину дел.
- Память и состояние в виде JSON, который нейронка правит через операции, - хороший способ не терять факты.
- Цена всему этому - скорость. На локальном железе многошаговый агент для интерактивного общения пока слишком медленный.
- Порядок полей в схеме ответа важен: сначала рассуждение, потом решение. Это дешёвая замена настоящему thinking.
- Большая модель без размышлений может быть лучше маленькой с размышлениями.